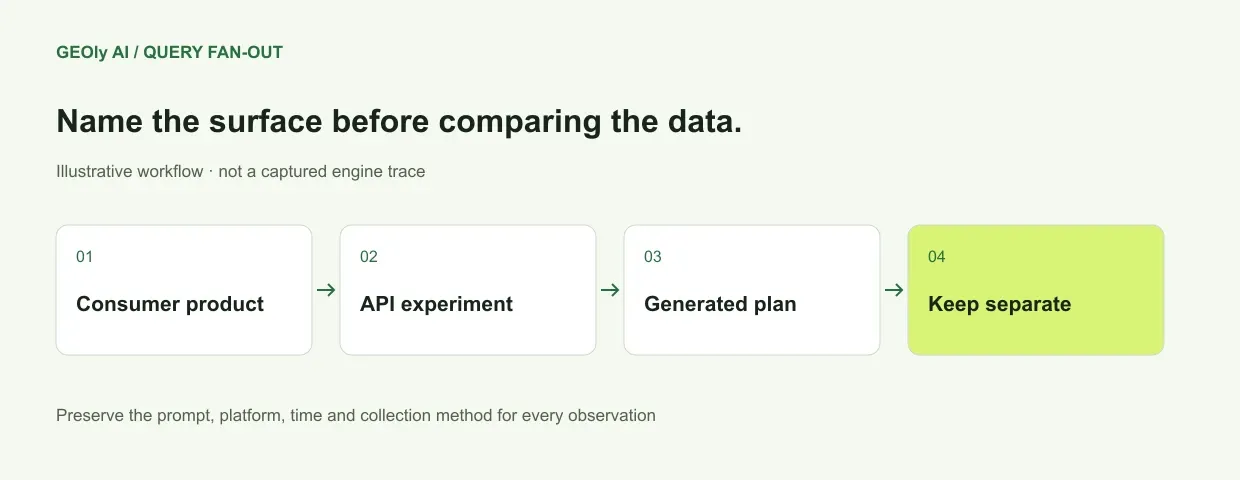
比较 Query Fan-out 时,应先说明观察的是哪个产品,以及证据如何获得。Google AI Mode、AI Overviews、消费者 ChatGPT 和 OpenAI API 实验都能使用网络信息,但这不意味着它们可以直接合并为一个数据集。
核心要点
- 平台公开描述检索机制,不等于承诺提供完整内部查询日志。
- API 搜索动作与消费端产品观测有不同的采集条件。
- 每条结果应关联原始问题、平台、日期与证据类型。
- 可以比较不同平台带来的内容决策,但数值比较需要一致的定义和样本。
Google:公开机制不等于公开日志接口
Google 文档说明 AI Mode 和 AI Overviews 可能使用 Query Fan-out,跨相关子主题和来源进行搜索。同一文档也提醒,这两种体验可能使用不同模型和技术。文档没有承诺固定的扩展数量,也没有承诺公开完整的内部搜索记录。Google Search Central
对内容规划而言,这支持我们调查相邻的信息需求;但不能据此把模型生成的列表标注为“Google 精确子查询”。如果工具声称提供观测记录,应进一步说明记录来源以及可能缺失的部分。
ChatGPT 产品观测与 API 实验
消费端观测记录某种采集方式在该产品上能够看到的信息;API 实验则使用开发者控制的请求与设置。即使输入措辞接近,两者也不是同一个实验。
OpenAI 网页搜索 API 文档描述了搜索调用条目与引用标注;搜索动作通常包含查询,但不保证每次都有。来源字段与回答内引用也有不同含义。OpenAI 官方文档
因此,API 可以用于可复核的检索实验,但它本身不能证明某个消费端会话搜索、展示或引用了什么。保留请求配置,明确标注 API 结果,不要在报表中悄悄替换消费者产品观测。
保留差异的比较表
产品或方式 | 应保留的信息 | 不能直接推断 |
|---|---|---|
Google AI Mode / AI Overviews 观测 | 产品、问题、日期、可获得的查询与来源 | 生成列表就是完整内部日志 |
ChatGPT 消费端观测 | 会话条件、可见搜索证据、答案引用 | 另一次运行会出现相同搜索 |
OpenAI 搜索 API 实验 | 请求设置、搜索调用输出、引用标注 | 结果复现消费者 ChatGPT |
模板或模型模拟 | 输入、生成分支、生成方式 | 任意一条分支确实被搜索 |
这是评估框架,并不表示 GEOly 提供表中的每一种采集方式。评估产品时应以实际提供的数据合同和样例为准。
建立可比较的观测表
每条采集查询保留父级观测记录,至少包括问题文本、平台界面、语言、已知的市场条件、观测时间、查询内容和采集状态。将完整答案及引用 URL 存在关联字段或记录中,确保可以返回原始证据。
不要因为提取器没有返回内容,就把字段写成“无”。应区分已采集、未暴露、采集失败和未知,否则技术缺失很容易被误读为搜索行为变化。
去重时保留原文与标准化文本。删除多余空格与合并语义相近问题不是同一种操作。若使用查询频次和问题覆盖数,也应同时保留:同一问题重复搜索,与多个问题都触发相同搜索,支持不同的分析结论。
如何做一个小型内容实验
从同一购买决策下的一组固定问题开始,例如代理商选择 AI 监测工具。采集初始窗口,检查哪些要求反复出现,再阅读现有页面是否用可核实的产品细节回答了这些要求。
每次做有限修改,例如明确平台范围、增加计费示例或写清设置条件。记录修改日期,在后续窗口沿用相同平台和问题集观测。解释变化时同时检查采集完整性与模型波动,不把前后相关性写成已经证明的因果关系。
GEOly 的查询分析功能页说明观测工作流,1,404 条查询案例展示如何从项目样本制定内容计划,而不是推算所有用户的需求规模。
常见问题
Google 与 ChatGPT 的 Fan-out 是同一种机制吗?
调查相关需求这一大方向可以比较,但实现、界面与可见证据不同。应依赖各自的平台观测,不能假设行为完全一致。
为什么两个工具给出的查询不同?
它们可能使用不同的问题、产品、设置、地区、时间或证据方法。先问清结果是模拟生成、消费端采集还是 API 实验,再做比较。