「我们怎么才能进 ChatGPT 的购物推荐?」是我们被问得最多的问题,而且它通常挂着一个错误的前提——以为存在一个提交表单,或者一个 SEO 技巧,或者一个能把位置买下来的广告产品。都没有。有的是一条依赖链,而大多数品牌断在比他们正在用力的那一层低得多的地方。
这是那本手册,来自 2026 年 10 月 21 日对 28 轮购物提问、97 个购买入口的实测,加上三份外部数据。顺序是刻意的:下面一层不成立,上面一层就没有意义。
要点速览
- 五层,按顺序:商品页 → 商品目录 → 来源在场 → 归因 → 付费协同。任意一层断裂,上游的投入都停止转化。
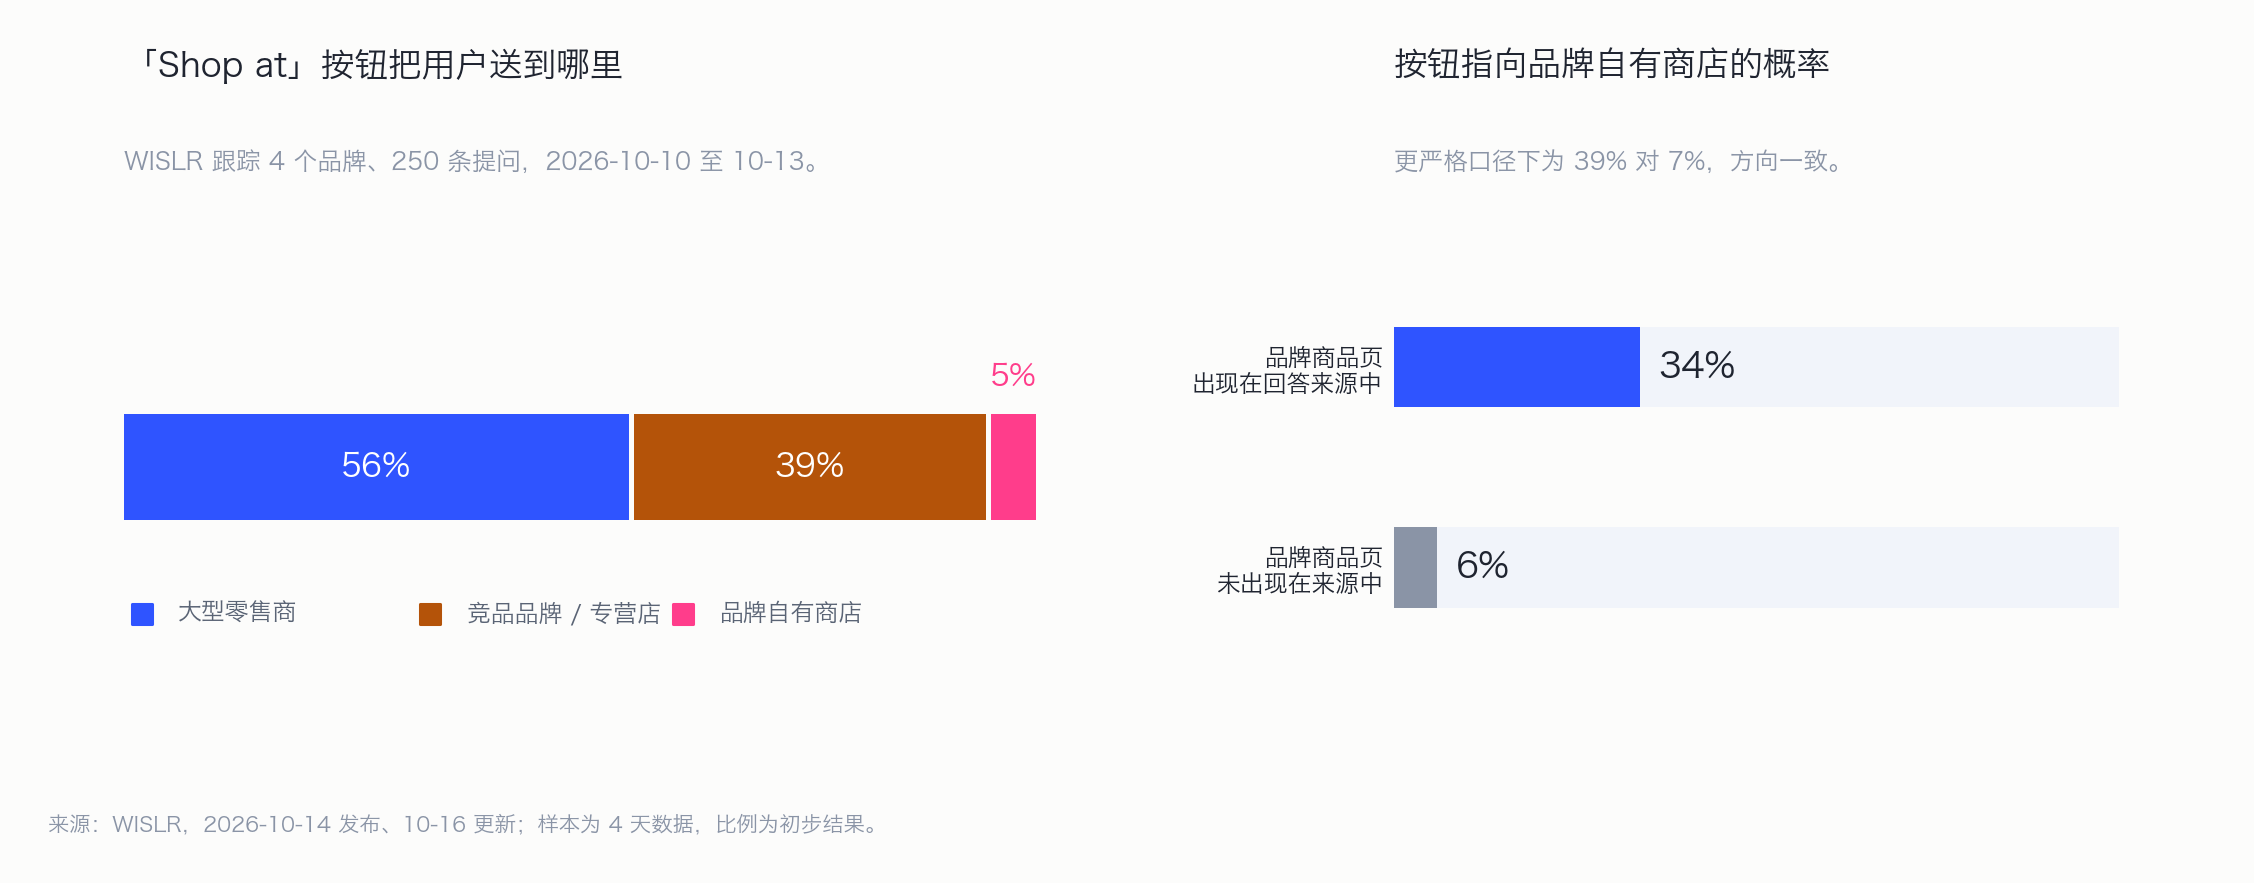
- 单项回报最高的动作是来源在场。被引用的品牌页拿到购买按钮的概率是 34%,未被引用的是 6%。
- 商品目录现在供给了 61.54% 的购物推荐,而 2026 年 7 月还是 8.26%。没有 Feed,就没有资格。
- ChatGPT 会在检索前改写购物者的问题。实测中它生成的检索词补上了年份、内容类型和人群限定——「best sleep earbuds stay in ears overnight side sleepers 2026 reviews」。
- 来源显示已收窄到每段一个站名。目标不再是成为一个来源,而是成为第一个来源。
- 推荐位买不到。广告与推荐是同一块屏幕上的两套系统。

L1 — 让商品页可被机器读取
这一层不起眼,而大多数失败恰恰住在这里。
- 把规格、价格、库存状态和适用场景写进服务端返回的 HTML。 不要藏在客户端脚本后面。验证方法:禁用 JavaScript 后查看源码,或者用
curl取页面看返回了什么。如果价格要等水合之后才出现,就当它不存在。 - 提供商品结构化数据——
Product、Offer、AggregateRating——价格与库存字段必须和页面上实际显示的一致。与可见页面互相矛盾的 schema 比没有 schema 更糟。 - 把「这是给谁用的」写出来。 实测中 ChatGPT 生成的检索词带着人群限定:side sleepers、college students。如果你的页面没有描述一件商品适合谁、在什么场景下用的语言,它就无法按这个维度被匹配。这是清单上成本最低、杠杆最高的一处文案改动。
L2 — 把商品送进目录
可抓取的页面已经不够了。自 2026 年 7 月 10 日起,大多数购物推荐来自商家商品目录,而不是网页。
- 先确认你确实在某个目录里,并把目录里的 SKU 数和你在售的 SKU 数对一遍。「我们以为平台处理了」是我们见得最多的缺口。
- 没有 Feed 基建就走 Shopify,它约占全部目录检索的 35%。
- 统一集团内每个店铺的价格与库存,并明确哪个店铺应当承接 ChatGPT 流量。我们看到过一件商品的购买按钮落到了兄弟品牌的商店,网址带
utm_campaign=openai_catalog——是目录在选,不是品牌在选。 - 把覆盖率当常态指标。 在 Profound 的样本中,687 家客户里有 450 家因这次通道切换损失了三分之一以上的购物可见度。
L3 — 把页面送进回答的来源
这是投入产出比最好的一层,也是大多数电商团队并不拥有的一层。
品牌商品页出现在回答引用的来源中时,购买按钮指向品牌自有商店的比例是 34%;不在时是 6%。按更严格口径是 39% 对 7%,方向一致。漏斗顶端五倍的差距,没有任何落地页优化补得回来。
对应的动作: